Александр Федоров
Руководитель проектов и аналитик данных. Веду разработку интеллектуальных и расчётных продуктов для нефтегазовой отрасли, до этого 8 лет был инженером-нефтяником, а начинал в отраслевой науке.
📍 Красноярск · готов к переезду (Москва, Санкт-Петербург, Казань) и командировкам · удалёнка / гибрид / офис
Обо мне
Руководитель проектов в нефтегазе — с февраля 2026 года веду проекты цифровизации добычи: от сбора требований и формирования методики до декомпозиции, контроля сроков и приёмки результатов. До этого 8 лет работал инженером-нефтяником, начиная с отраслевой науки, и год — аналитиком данных. В проектную роль пришёл из практики: когда автоматизировал разбор неструктурированных отчётов и сократил время их обработки с нескольких часов до 5–10 минут, понял, что моя сильная сторона — превращать рутинные процессы в работающие инструменты и доводить их до внедрения.
Сейчас веду кросс-функциональную команду (аналитики, backend, frontend, QA, DevOps): ИИ-помощник по надёжности трубопроводов, расчётное ядро для добывающих активов, внедрение LLM-извлечения данных из документов. Отвечаю за методику, планирование этапов, контроль сроков, коммуникацию с заказчиками и приёмку. Инженерное прошлое позволяет говорить с технологами на одном языке, а аналитический опыт — ставить команде проверяемые требования и принимать решения на данных, а не на мнениях.
Постоянно учусь и сразу применяю на практике: прошёл несколько программ Karpov.courses (аналитика данных, системная аналитика, ML-инжиниринг, A/B-тесты, инженерия данных, RAG-боты и агенты LLM) — это позволяет грамотно ставить задачи разработке и проверять качество результата. Легко нахожу общий язык с разными людьми — за годы работы в крупных компаниях научился объяснять сложное простыми словами. Английский подтягивал в том числе на практике — по программе Work and Travel в США. Вне работы 11 лет играю в хоккей.
Опыт работы
Руководитель проектов
Oil and Gas Production Tools
Дополнительно к аналитике веду продуктовые направления как руководитель проектов (подробнее — в разделе Проекты):
- Веду продукт — ИИ-помощник для эксплуатации и надёжности трубопроводов.
- Расчётное ядро для добывающих активов заказчика (микросервисы Python + React).
- Руковожу кросс-функциональной командой: аналитики, backend (Python), frontend (React), QA, DevOps.
- Собираю и согласую требования, формирую методику, декомпозирую на этапы, отвечаю за приёмку.
Аналитик данных
Oil and Gas Production Tools
Связующее звено между инженерами-нефтяниками и ML-командой при разработке интеллектуальных цифровых помощников для отрасли.
- Собираю требования у экспертов и перевожу их в ТЗ для ML-команды.
- Провожу EDA: чищу датасеты, работаю с пропусками, аномалиями, дисбалансом классов.
- Строю пайплайны автоматической валидации моделей и дашборды мониторинга метрик.
- Сократил обработку разнородных отчётов с часов до 5–10 минут (точность >92%).
- Уменьшил время ручной проверки валидации на 60%, повысил Recall критичных осложнений на 15%.
Менеджер отдела планирования и мониторинга новых скважин
РН-Ванкор
- Разрабатывал алгоритмы расчёта запускных показателей (РИГИС, ОФП, PVT-модели).
- Создавал модуль оценки скважин-кандидатов и подбора эффективных ГТМ.
- Продвинутый Excel/VBA, Power Query, гидродинамическое ПО (Petrel/tNavigator/Eclipse).
Главный специалист отдела планирования и мониторинга новых скважин
РН-Ванкор
- Геологическое сопровождение бурения 130 скважин (эффективная проходка 80–85%).
- Запланировал реконструкцию 90 скважин методом ЗБС, организовал бурение 40 скважин.
- Внедрил модуль прогнозирования запускных показателей и систему подбора ГТМ.
Ведущий инженер отдела планирования и мониторинга новых скважин
РН-Ванкор
- Готовил геологические проекты на бурение, схемы кустования и заканчивания.
- Анализировал расхождения план/факт, актуализировал ПДГТМ.
Инженер сопровождения ГРП
ЛУКОЙЛ-Инжиниринг (КогалымНИПИнефть)
- Проектировал операции ГРП (FracPro / Meyer / GOHFER), сопровождал полевые работы.
- Спроектировал 45 операций ГРП с эффективностью 85% (выше среднего по отрасли 70–75%).
Стажёр
ЛУКОЙЛ-Инжиниринг
- С нуля создал базу данных месторождений с геолого-физическими характеристиками и динамикой разработки — научился структурировать неструктурированные данные.
- Прогнозировал показатели добычи через построение характеристик вытеснения и подбор месторождений-аналогов.
- Численное моделирование процессов прорыва воды — работа с многопараметрическими зависимостями.
Техник кафедры РиЭНМ
РГУ нефти и газа (НИУ) им. И.М. Губкина
- Проводил экспериментальные исследования: анализировал характеристики насосов и процессы вытеснения на 20-метровых моделях.
- Научился работать с экспериментальными данными, выявлять закономерности и делать выводы на основе измерений.
Проекты
Рабочие проекты; роль — в плашке каждого.
ИИ-помощник для эксплуатации и надёжности трубопроводов
Система поддержки принятия решений по эксплуатации и надёжности трубопроводов: на основе данных объекта помогает инженеру формировать обоснованные рекомендации, сокращая рутинный аналитический разбор.
- Гибридный подход: сочетание детерминированной логики и генеративного ИИ (LLM/RAG).
- Работа с большим объёмом разнородных данных и документации.
- Режим поддержки решений — итоговое слово остаётся за инженером.
Моя роль: постановка задачи и методология, координация ML-инженеров, backend и предметных экспертов, приёмка результатов.
Расчётное ядро для добывающих активов
Заказчик — крупная нефтегазовая компания (под NDA).
Набор расчётных микросервисов для инженерного анализа скважин: физика пласта и ствола «под капотом», результаты сверяются с эталонным ПО. Два актива:
- PVT-модуль: свойства газа из компонентного состава (z-фактор, вязкость, Bg).
- Приток (IPR) и расчёт потока в стволе (VLP) с многофазными корреляциями.
- Материальный баланс с аквифером, диагностика p/z и адаптация запасов на историю.
- Единый PVT-модуль (нефть / газ / вода), IPR по каждому пласту.
- VLP с моделью клапана ОРЭ и насоса ЭЦН, узловой анализ (поиск рабочей точки).
- Диагностика режима и разнесение добычи по пластам, подбор оптимального режима.
- Материальный баланс, деклайн-анализ и расчёт КИН по объектам.
- Роль руководителя: сбор и согласование требований (User Stories), методология расчётов, декомпозиция на этапы/инкременты, координация команды (аналитики, backend Python, frontend React, QA, DevOps, дизайнер), приёмка результатов.
Извлечение данных из документов с помощью LLM
Заказчик — нефтегазовая компания (под NDA), 2026.
Система превращает неструктурированные документы — PDF, DOCX, сканы — в заполненные поля: пользователь описывает шаблон, загружает документы и проверяет результат, где сомнительные значения подсвечены по уверенности.
- Конвейер сам выбирает стратегию: текст или изображения страниц, документ целиком или поиск нужных фрагментов (RAG с гибридным поиском и переранжированием).
- Локальные open-source модели в контуре компании: документы не уходят во внешние сервисы.
- Проверка на галлюцинации, генерация шаблона по образцу документа, выгрузка в Excel, журнал событий ИБ.
- FastAPI, обработчик задач на Redis Streams, PostgreSQL, MinIO, React.
Моя роль: бизнес-требования и ТЗ, функциональные требования, тестирование и оценка качества извлечения, документация, участие в разработке.
Инженерный расчётник скважины: перенос Excel/VBA на Python
Расчётная методика — из рабочего инструмента инженеров. Исходная книга и данные не публикуются, примеры обезличены.
РИГИС на входе — дебиты нефти, жидкости и воды по каждому интервалу и по стволу в целом, оптимальная расстановка фильтров с изоляцией обводнённых участков пакерами, раскладка хвостовика, прогноз с конусами воды и газа, экономика. Вторая часть — расчёт добычи по рейтингу ГТМ: запасы, КИН, помесячный профиль с ППД.
- Формулы перенесены дословно и сверены с кэшем книги: РИГИС и рейтинг ГТМ — до 1e-9, палетки заводнения — до 1e-12.
- Подбор фильтров вместо «Поиска решения» Excel сделан точным: динамическое программирование по срезам с итерациями на взаимовлияние секций и перетоки.
- Побочный результат: на той же скважине «Поиск решения» застревал в локальном оптимуме и давал 329,3 т/сут при любом пределе обводнённости от 5 до 98 % — точный подбор даёт 532,8 и 604,7 т/сут.
- В самой книге найдены ошибки, включая ошибки в VBA, сохранённые ради совпадения
расчёта, — разобраны в
docs/PORTING.md. Python-пакет с тестами, CLI и интерфейсом на Streamlit.
Моя роль: перенос методики, расчётное ядро и интерфейс, сверка с книгой, руководство пользователя и разбор найденных расхождений. Код и документация →
Pet-проекты
Симулятор A/B-тестов ↗
Интерактивный инструмент: калькулятор размера выборки, визуализация мощности и Монте-Карло симуляция тысяч экспериментов — ошибки I/II рода, «проклятие победителя», поведение p-value. Чистый HTML + JavaScript, без библиотек; расчёты сверены с эталонными значениями.
Движок анализа A/B-экспериментов ↗
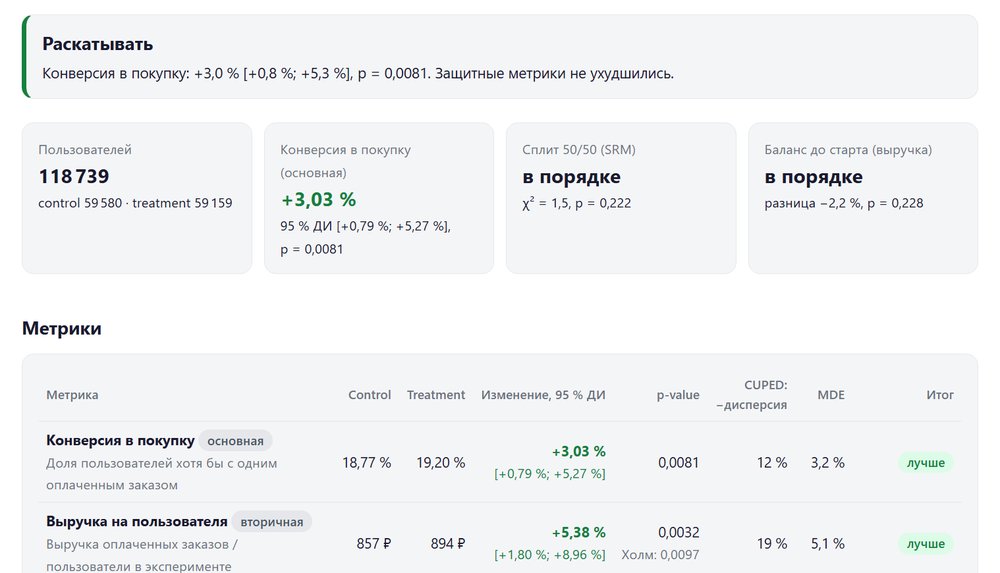
Python-пакет, который делает с A/B-тестом то же, что платформа экспериментов: логи в DuckDB → метрики на SQL → проверки здоровья (SRM, баланс групп до старта) → CUPED, дельта-метод и линеаризация для метрик-отношений, поправка Холма, последовательный анализ (mSPRT, О'Брайен — Флеминг) → решение и HTML-отчёт. Каждый метод проверен на 3 000 симулированных экспериментов: CTR «по просмотрам» даёт 25 % ложных срабатываний вместо 5 %, ежедневное подглядывание — 22 %, CUPED поднимает мощность с 72 до 79 %. Отчёты распознают сломанный сплит и пострадавшую защитную метрику. Тесты и CI.
A/B-кейс на реальных данных: какую email-рассылку слать и кому ↗
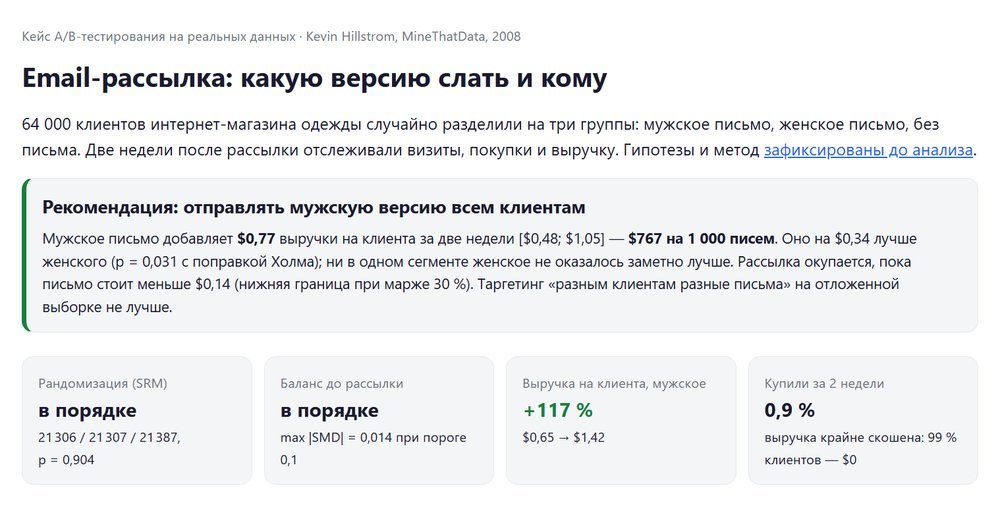
Настоящий рандомизированный эксперимент интернет-магазина (64 000 клиентов, три группы: мужское письмо, женское, без письма). Сделано как в рабочей практике: план анализа с гипотезами зафиксирован в git до расчёта результатов, затем проверка рандомизации, подтверждающие гипотезы с поправкой Холма, бутстреп для скошенной выручки, экономика рассылки и таргетинг с проверкой на отложенной выборке. Итог: мужское письмо даёт +$0,77 выручки на клиента ($767 на 1 000 писем) и лучше женского; красивая гипотеза «письмо должно совпадать с интересами» не подтвердилась, а дробный таргетинг переобучился. Статистика — из собственного пакета abengine.
Метрики интернет-магазина: что случилось с выручкой ↗
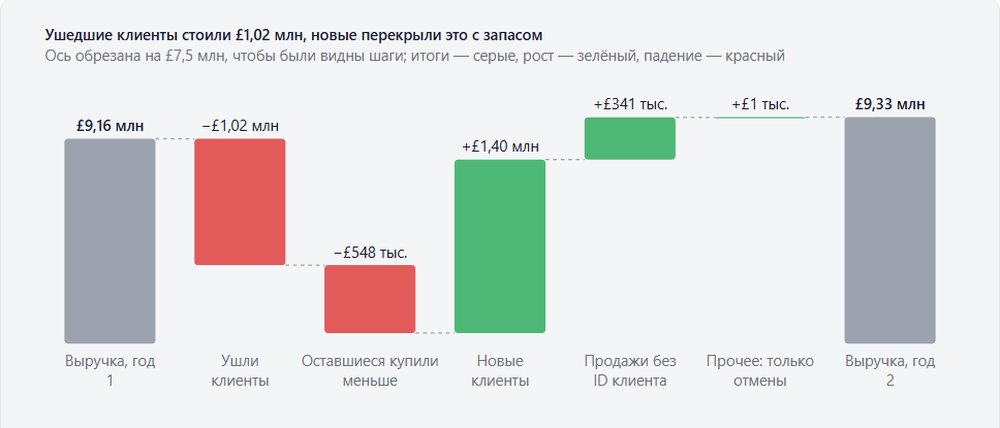
Реальные транзакции британского интернет-магазина (1 млн строк чеков, 2009–2011) — путь BI-аналитика от сырых чеков до решения: очистка с измеренным влиянием каждого правила, SQL-витрины в DuckDB, словарь метрик и дерево выручки, мост выручки год к году и разложение «клиенты × частота × средний чек», когорты удержания, RFM-сегменты. Итог: выручка +1,9 %, но постоянные клиенты покупают на 8 % реже, а рост дали заказы без ID и новые клиенты. Дашборд в Metabase, собранный «как код» через API, и записка с рекомендациями.
Кошелёк от транзакции до решения: PostgreSQL → CDC → ClickHouse → dbt ↗
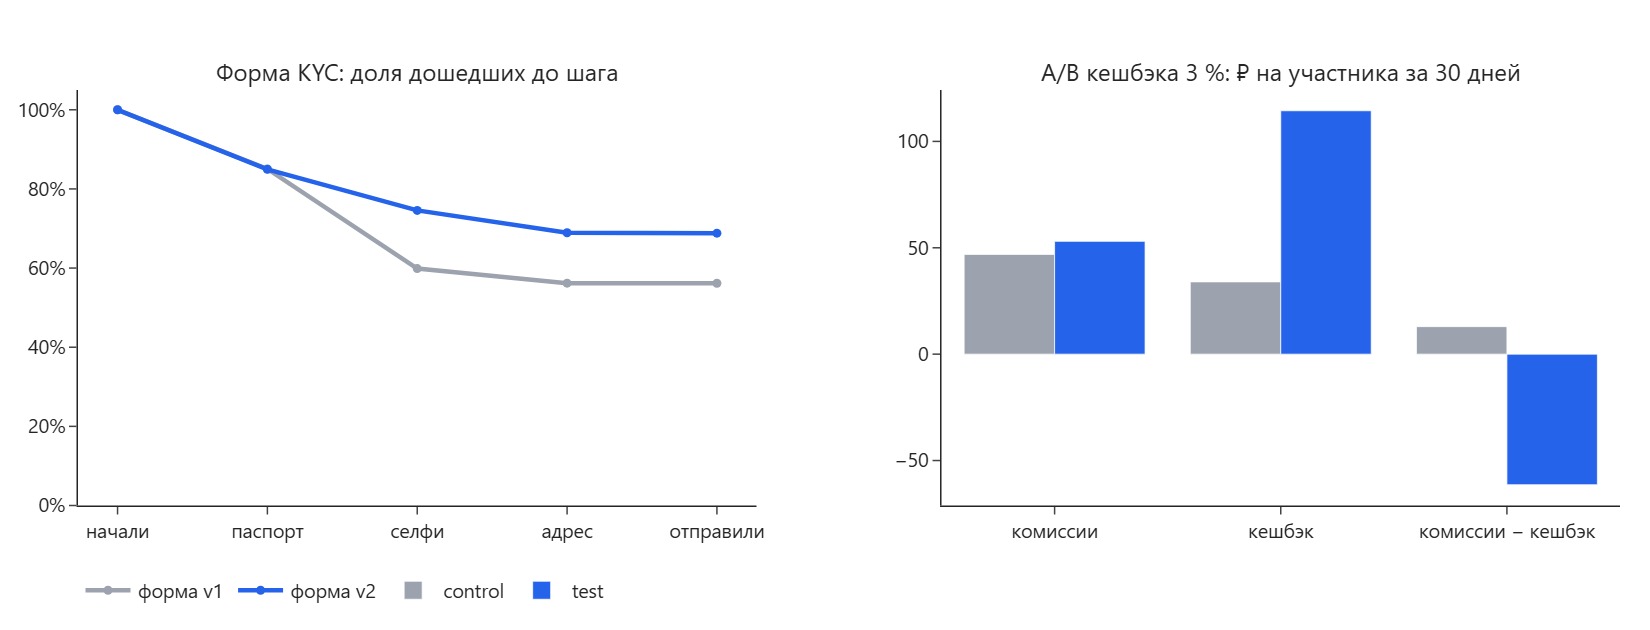
Сквозной проект за три роли аналитика на домене электронного кошелька.
Системный: требования, сценарии, ER-модель, автоматы состояний, OpenAPI,
контракт событий. База данных: двойная запись и инварианты денег в схеме,
идемпотентность, RLS и маскирование ПДн; 16 тестов воспроизводят потерянное обновление, write skew
и дедлок — и нашли настоящий дедлок FOR UPDATE против блокировки внешнего ключа.
Инженер данных: Debezium CDC без ПДн → Redpanda → ClickHouse, ELT в dbt, SCD2 из журнала
изменений, поздние и повторные события, 49 тестов, сверка с источником до копейки.
Продукт: воронки по каналам, эффект новой формы KYC (56 → 69 %), A/B кешбэка 3 %
(+13 % покупок, но −74 ₽ на клиента — не раскатывать), сбой провайдера и антифрод-правило.
Весь стек поднимается в Docker одной командой.
Рекомендации музыки: двухэтапная система на данных Яндекс Музыки ↗
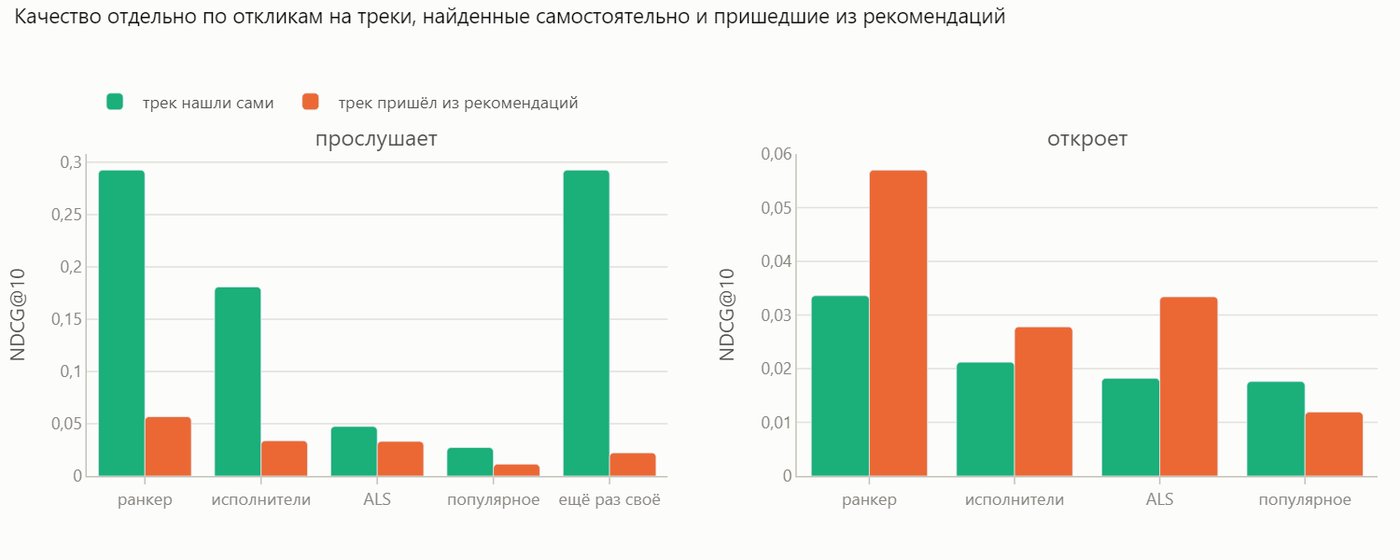
Рекомендательная система на открытом датасете Yambda-50M (47,8 млн событий): кандидаты из пяти источников (ALS, «слушают вместе», исполнители, популярное, «ещё раз своё») и ранжирование LightGBM LambdaRank. План до обучения, проверка только по времени, тестовая неделя открыта один раз, ДИ бутстрепом. Две задачи: «прослушает» и «откроет» — 71 % прослушиваний оказались повторами. В открытиях ранкер лучше ALS на +75 % NDCG@10; в «прослушает» его выигрыш целиком на треках из старых рекомендаций — смещение обратной связи, которое не видно в общей метрике. Абляция: из пяти источников нужны два. Отчёт, тесты и CI на GitHub (Alex91132/music-recsys).
Рынок жилья Парижа: EDA 317 тыс. сделок ↗
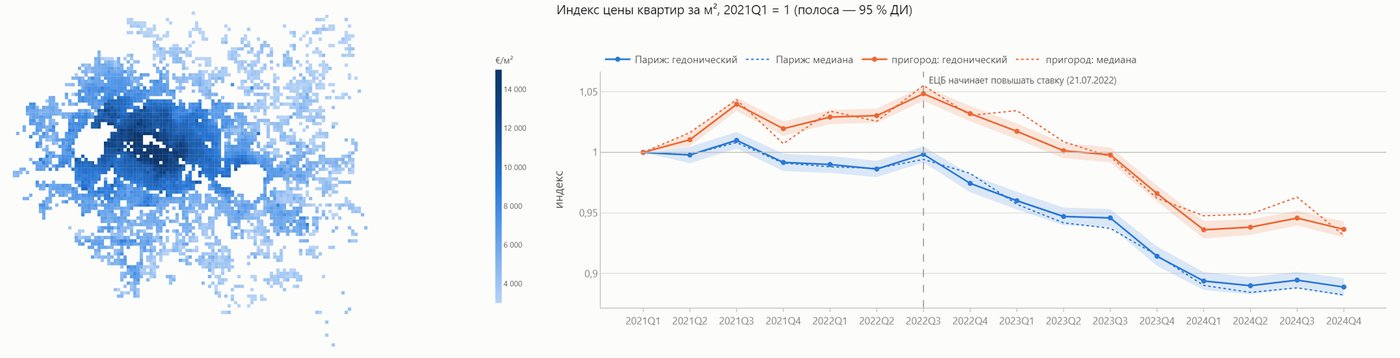
Разведочный анализ всех нотариальных продаж жилья в Париже и ближнем пригороде за 2021–2024 (открытый реестр DVF). Каждая гипотеза проверена статистикой: регрессия с фиксированным эффектом квартала 300 × 300 м, кластерные ошибки, бутстреп, перестановочный тест. После подъёма ставок Париж потерял −12 % от пика, сделок стало меньше на 20–38 %; дорогие округа упали меньше (ρ = 0,94). Три наивных вывода не пережили проверки: премия новостроек не +2 %, а +24 %; большие квартиры в пригороде дешевле студий за м², а не дороже (парадокс Симпсона); эффекта Олимпиады нет (p = 0,63). Интерактивный отчёт с картами; ноутбук, тесты, код и пошаговое руководство по EDA — на GitHub (Alex91132/paris-dvf-eda).
Ковёр бурения — график движения буровых установок ↗
Загрузите графики бурения одного или нескольких месторождений — страница построит ГДБУ по месяцам: в каком порядке каждая бригада обуривает кусты, даты начала и окончания бурения куста, число скважин, вышкомонтажные работы между кустами и простой установки — часть промежутка, не покрытая ни одной работой по графику. Проверки ловят пересечение кустов у бригады и переход без времени на ВМР. Сверено с ручным ГДБУ из Excel: все 49 фактических кампаний двух месторождений совпали по датам и числу скважин. Ядро без DOM с тестами, чистый JavaScript + SVG; файлы обрабатываются в браузере.
Платформа данных нефтедобычи: PostgreSQL → Airflow → ClickHouse → Superset ↗
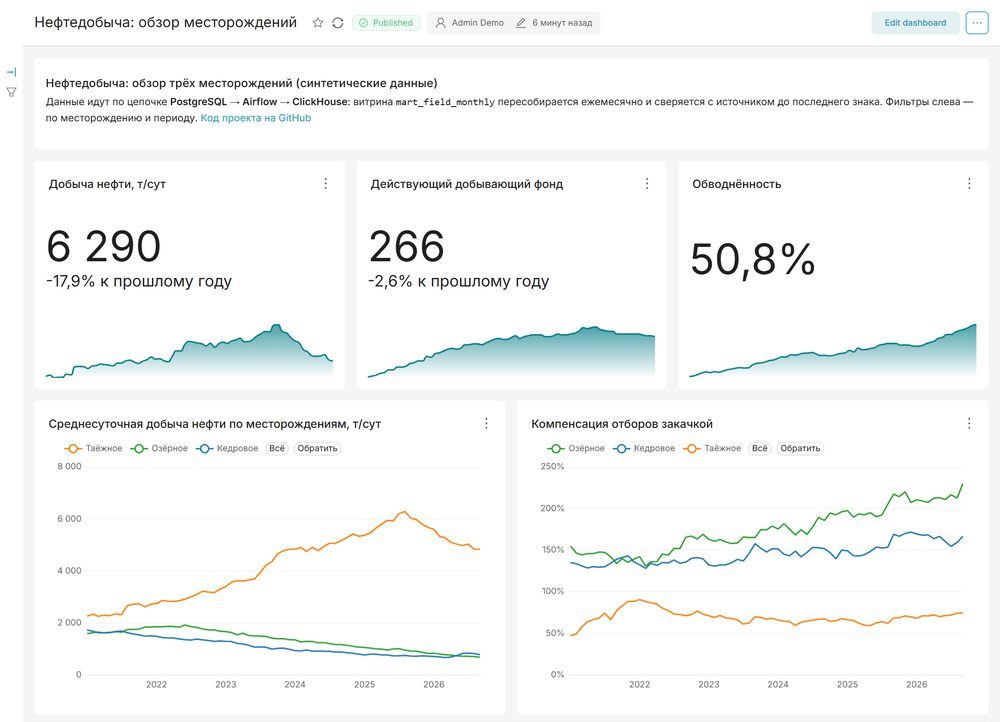
Спроектированная с нуля БД: месторождения, скважины, суточная добыча, ГТМ и график буровых. Целостность на уровне БД (составные FK, EXCLUDE-ограничения на пересечение периодов), партиционирование, BRIN-индекс с подобранной настройкой — замеры через EXPLAIN ANALYZE. 11 аналитических запросов: эффективность ГТМ, компенсация отборов, «острова и пропуски» в простоях, ROLLUP. Хранилище: ETL на Airflow в ClickHouse со схемой «звезда» — идемпотентная загрузка с атомарной подменой партиций, backfill истории, сверка с источником до последнего знака. Дашборд: Superset «как код» — графики, метрики и фильтры создаются скриптом через REST API. Синтетические данные по модели Арпса, весь стек поднимается одной командой в Docker.
Сколько нефти дал ГРП: причинный анализ эффекта ГТМ ↗
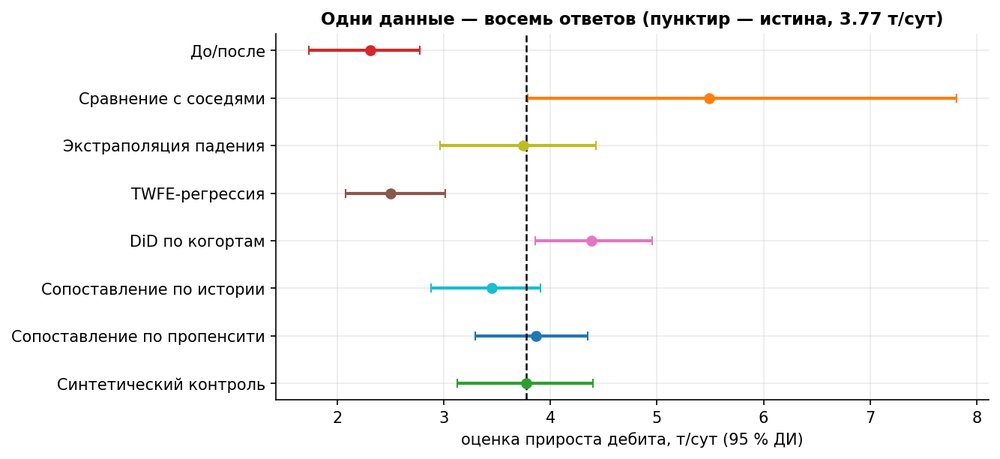
Восемь методов оценки эффекта ГРП — от отраслевого «до/после» и экстраполяции падения до разности разностей, сопоставления по пропенсити и синтетического контроля — сравниваются с известной истиной: данные сгенерированы так, что добыча каждой скважины известна и с ГРП, и без него. Монте-Карло на ~2 000 месторождений: «до/после» занижает эффект на треть, DiD попадает в «провал Ашенфельтера» и находит эффект там, где его нет, подбор контрольной группы ошибается на 1–2 %. Кластерный бутстреп и проверка покрытия интервалов, тесты и CI. Интерактивная демо на чистом JavaScript, разбор — в Jupyter.
Литология по каротажу: ML-модель и сервис ↗
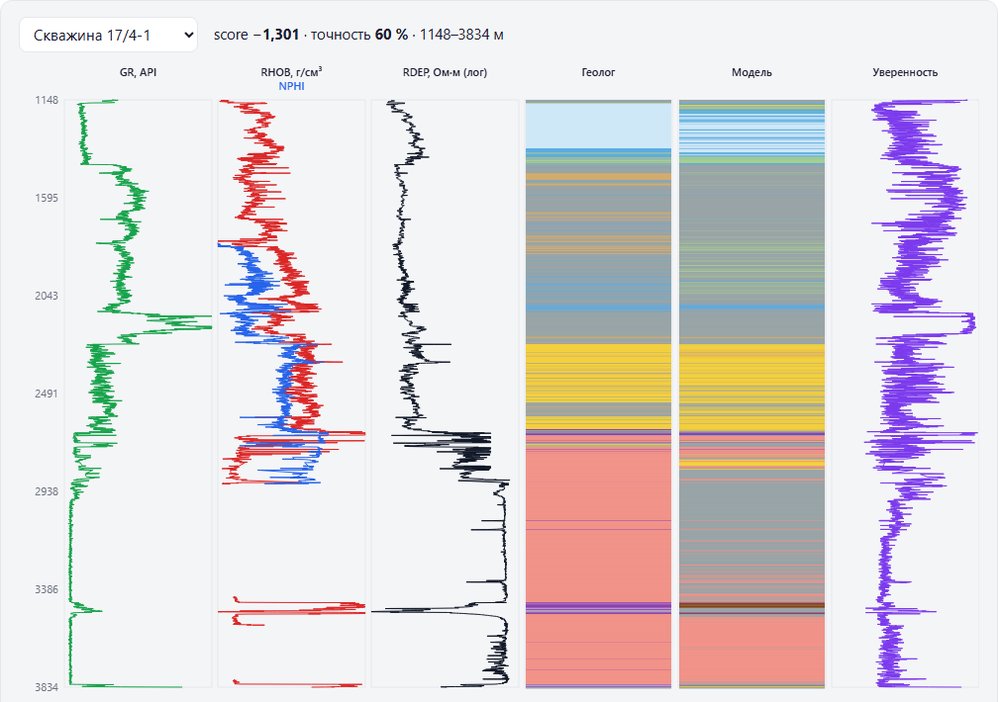
LightGBM определяет породу в каждой точке ствола по каротажу — реальные данные соревнования FORCE 2020, 118 скважин Норвежского шельфа. План зафиксирован в git до финальной оценки; случайное разбиение по точкам обещало качество в 3,4 раза лучше реального, честная проверка — по скважинам. На 10 скрытых скважинах финала модель сравнивается с 13 командами-финалистами (13-е место из 14), а провал на соляной скважине разобран: гипотеза проверена на CV и не подтвердилась — причина в данных. Сервис на FastAPI в Docker: LAS на входе, литология и предупреждения на выходе — об ошибке единиц и о скважине, непохожей на обучающие. Тесты и CI.
HR Analytics: почему уходят сотрудники ↗
EDA на IBM HR dataset (1470 сотрудников): сверхурочные — главный драйвер оттока (30% против 10%, риск 2.9×). Хи-квадрат + Cramér's V, Манн-Уитни + Cohen's d, лог-регрессия (AUC = 0.80), карта рисков стаж × переработки. Рекомендации для HR: контроль переработок для новичков, программы удержания 18-30 лет.
Volve Survival: время до обводнения скважины ↗
Анализ выживаемости на реальном месторождении: закрытие поля в 2016 году — административное цензурирование, и без survival-подхода время до обводнения занижается. Каплан–Мейер и log-rank реализованы с нуля (без библиотек), чувствительность к порогу «прорыва», и честная демонстрация того, почему модель Кокса на шести скважинах неинформативна (бутстреп-ДИ шире оценки).
Volve ML: прогноз дебита на месяц вперёд ↗
Регрессия по истории скважин (лаги, скользящие, режимы работы): градиентный бустинг против наивного и decline-бейзлайнов при бэктестинге раскрывающимся окном — без утечек будущего в прошлое. MAE 64 против 115 м³/сут (−44%); честная оговорка: без логарифмирования цели модель бейзлайны проигрывает — и это разобрано. Разбор ошибок по режимам работы скважин.
Volve: анатомия месторождения — EDA ↗
Разведочный анализ реального морского месторождения Volve (Equinor, открытые данные): 7 скважин, 9 лет суточных замеров. Не «посмотрим на распределения», а гипотезы и проверки — и две из них не пережили проверки. «Эффект перезапуска» наивное «до/после» завышает вдвое: плацебо-окна без остановок показывают естественное падение добычи, а после поправки на тренд эффект держится на одной поздней скважине. «Связь закачки с водой» оказалась общей причиной — простоями платформы; обычный бутстреп занижал интервал, блочный довёл его до нуля. Decline флагманской скважины — с интервалом Ньюи — Уэста. Полный раздел качества данных.
REST API на FastAPI ↗ в разработке
Микросервис-каталог объектов: FastAPI + SQLModel + PostgreSQL. Уже реализовано: эндпоинты списка и карточки, фильтрация по цене и сортировка, типизированные ответы (Pydantic), внедрение зависимостей, слоёная архитектура (api / core / db / schemas). В планах: чтение из БД вместо демо-данных, тесты и документация.
Чат-бот для работы с документами (RAG/LLM)
Бот, отвечающий на вопросы по документам (RAG). Репозиторий пока не опубликован.
Навыки
Языки и анализ
Базы данных и хранилища
Визуализация
Инженерия данных и инфраструктура
Обучение и курсы
Английский — B2. Постоянно повышаю квалификацию — в основном на Karpov.courses:
Из блога
25 августа 2026Как я пришёл в аналитику данных
Путь от инженера-нефтяника к data-driven решениям.